openspec & AI开发工作流
OpenSpec 的核心理念是:在编写任何代码之前,你和你的 AI 必须就要构建什么达成一致。不过,这种共识只有在你真正阅读了 AI 所编写的内容之后才具有意义。
概要讲解
先快速过一下openspec 工作流,也便于快速上手,如下图。
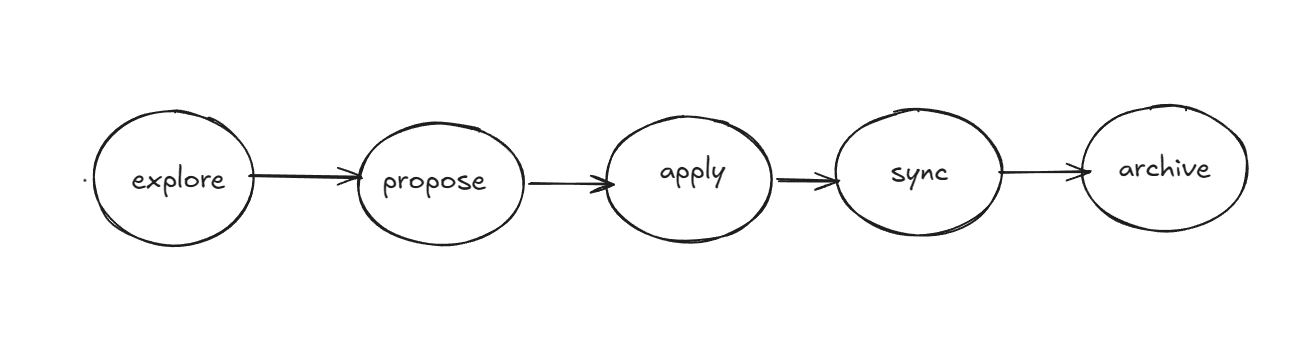
| 阶段 | 核心作用 |
|---|---|
explore |
调研问题、理解代码、分析方案 |
propose |
定义这次改什么,生成方案、规格和任务 |
apply |
按任务实施代码 |
sync |
把本次增量规格合并到正式规格 |
archive |
把完成的 change 移入归档目录 |
详细的command 可以查阅官方github描述:
 Fission-AI
propose 之后会生成以下文件:
(for spec-driven: proposal, specs, design, tasks)openspec/changes/add-dark-mode/
├── proposal.md 1. 意图与范围 ← 如果这里错了,就停在这里
├── specs/…/spec.md 2. 需求 ← 审查的核心
├── design.md (仅用于较大的变更)— 技术方案
└── tasks.md 3. 工作计划propose指令示例
生成的这些文件是否要阅读呢?下面重点讲述。
这个赌注很简单:在一个只有一段代码的计划中犯低级错误几乎是不费力的。而要在 300 行代码中犯同样的错误则非常困难。而审查过程正是你实现这一赌注的机会。
接下来,我以从0开发 一个防微信的apk 为例子,具体展开。
proposal.md : 第一个就是要阅读这个文件,通过一两段文字就能把握其中的“原因”和“内容”——即目的、范围以及处理方式。
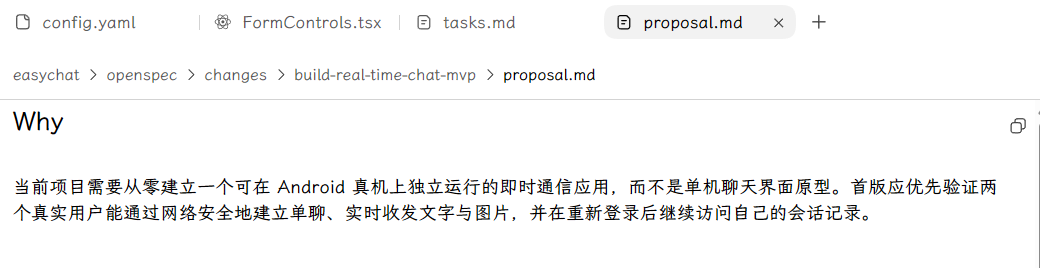
如果proposal 都不是你当下要做的大意,那么之前跟AI聊方案肯定有问题。
那么具体有什么评判的标准呢?
- 比如说,写的范围扩大了,我明明之前跟AI聊是一个主题切换的功能,但是proposal也涉及了认证相关的内容。
- 说的比较模糊,比如“改进设置页面”并不明确具体要做什么;“添加一种能够尊重操作系统偏好设置的深色模式选项”则比较具体一些。
spec.md:spec 是一份行为契约,而不是实施计划。
这是在回答:“什么情况下,系统应该表现成什么样”
举个例子,让AI加一个「用户登录」功能
我们可能会自然地写:
加一个登录接口,用户名密码登录,登录成功返回JWT,失败返回401。
这已经有点spec 的味道了,但还不够完整。
# User Login

## Requirements

### Requirement: 用户可以使用用户名和密码登录

系统 SHALL 允许已注册用户通过用户名和密码进行身份认证。

#### Scenario: 登录成功

- GIVEN 用户已经注册
- AND 用户提供正确的用户名和密码
- WHEN 用户提交登录请求
- THEN 系统 SHALL 返回认证 Token
- AND Token SHALL 在 24 小时后过期

#### Scenario: 密码错误

- GIVEN 用户已经注册
- AND 用户提供错误的密码
- WHEN 用户提交登录请求
- THEN 系统 SHALL 返回 401
- AND 系统 SHALL NOT 返回 Token
task.md : 把设计方案拆解成可执行步骤的实施清单。
格式一般如下:
## 1. 数据库改造

- [ ] 1.1 给订单表增加 cancel_reason 字段
- [ ] 1.2 编写数据库迁移脚本
- [ ] 1.3 更新 Order 数据模型

## 2. 取消订单逻辑

- [ ] 2.1 增加取消订单接口
- [ ] 2.2 校验订单当前状态
- [ ] 2.3 释放已锁定库存
- [ ] 2.4 退还优惠券

## 3. 测试验证

- [ ] 3.1 编写正常取消的单元测试
- [ ] 3.2 测试已支付订单不能直接取消
- [ ] 3.3 测试重复请求的幂等性它在工作流中的作用,执行opsx:apply ,AI 会读取 task.md :
- 找到尚未完成的
- []任务 - 按任务实施代码修改
- 运行相关测试
- 完成后标记为
- [x] - 中断后再次执行时,从第一个未完成任务继续。
检查完上述之后,就开始执行apply,生成一版代码。生成完成之后,使用`verify` 去检验代码和文档是否一致。
如果这个时候产品突然变卦,功能有一点要补充。那么意味着我们上述的文档和代码都要发生变化。这个时候,可能有点同学想着,改动不大,直接指挥AI 改吧。省点事情,这个千万不可取。这个会严重毁坏代码和文档的一致性。那么直接指挥AI去对齐文档是否可行?这个只能说比较依靠模型在当前上下文的智力情况。没有一些一致性的保障。
这个时候给大家介绍一个非常好用的openspec扩展的指令:update
/opsx:update 是 v1.6.0(2026-07-10)才进默认工作流的。1.0 的 OPSX 里没有这条命令。
版本时间线
| 时间 | 发生了什么 |
|---|---|
| v1.0.0(2026-01,OPSX 发布) | 命令是 explore / new / continue / ff / apply / verify / sync / archive… 没有 /opsx:update。文档已经写“随时改任意 artifact”,但只能手改 Markdown。 |
| 之后几个月 | 用户反复踩坑:改了 design.md,tasks.md 还是旧的;想改计划,AI 却开始写代码。 |
| PR #1278(clay-good,2026-07-07 合入) | 真正落地这条 skill:feat(skills): propose /opsx:update planning-artifact update skill |
| v1.6.0(2026-07-10) | Release 标题就是 OPSX Update, Tool Support。CHANGELOG:Update planning artifacts in place。进入 core profile。 |
发布说明原话:用 /opsx:update 原地改现有 change 的计划,并把相关 artifact 对齐,实现工作仍交给 /opsx:apply
所以正确的做法是,先update 说明变更(依靠openspec的一致性校验)再 apply。就显得非常丝滑了。
apply 比较简单,直接appy 对应的change 名称就行。
最后是verify,校验文档和代码的一致性。
AI开发工作流
首先说一下,我平时会用哪些插件或者skill去提升开发效率
别让 Agent 再靠 grep / glob / 逐文件 Read 去“摸索”项目结构,先给它一张地图。
它解决了AI Agent 改代码、答架构问题前,往往先花大量token 做“发现”。
- 搜文件名、读import、追调用链
- 一次任务可能要十几次工具调用、读很多文件
- 大仓库里成本高、慢、还容易漏关系
codegraph把这一步前置:离线建好索引,Agent 直接查图。
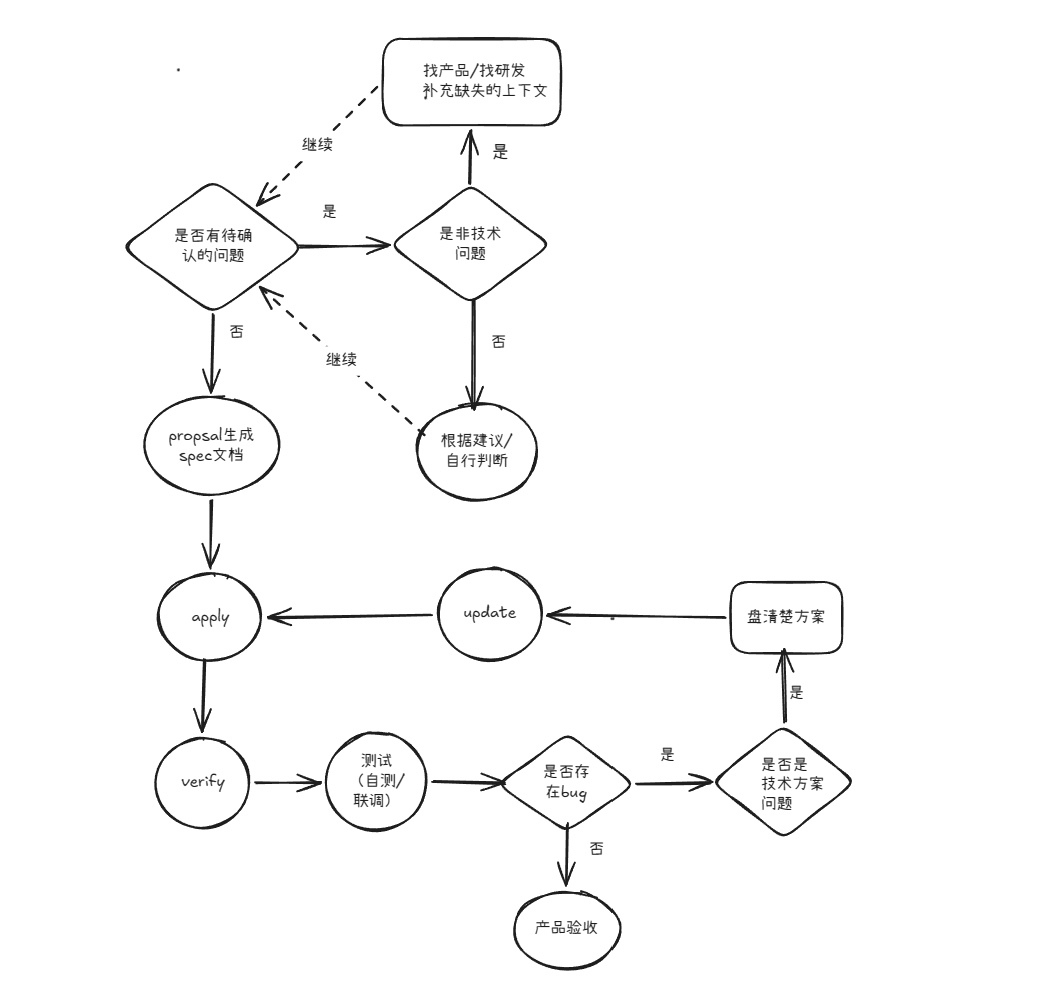
下面这个是作者平时开发的工作流,也就是这样了。
 赣公网安备36102702000155号